
Ya conoces la rutina. La sesión salió bien, el director quedó contento, le das a stop y ahí está: un WAV de 57 minutos con unas 800 tomas dentro. Entonces empieza el segundo trabajo. Hacer zoom, buscar el silencio, cortar, hacer zoom, buscar el silencio, cortar. Arrastrar las buenas a otra pista. Intentar recordar si aquello era la línea 14 o la 15. Tres horas después estás ordenando clips de oído y la tarde se ha esfumado.
¿Te suena?
Aquí va la respuesta directa. Una sesión larga se divide detectando el silencio: cualquier tramo en el que el nivel se mantiene por debajo de un umbral durante más de un tiempo mínimo es un hueco entre tomas, y ahí cortas, dejando un poco de ruido de sala a cada lado. Para meter las piezas en FL Studio en orden, nombras los archivos de forma que se ordenen como tú quieres y los sueltas en el playlist de una sola vez. Y para tener orden de guion en vez de orden de grabación, necesitas saber a qué línea pertenece cada toma, lo que significa pegar tu guion y, si quieres, dejar que una pasada de transcripción empareje las tomas con él.
Todo eso puedes hacerlo a mano. O puedes usar Takekeeper, una herramienta gratuita que construí y que hace la parte mecánica en el navegador de tu equipo. Sin cuenta, sin registro, y la grabación nunca sale de tu máquina: se lee del disco dentro del navegador y las exportaciones se escriben de vuelta en el disco. En la sesión de referencia (57 minutos, 848 tomas, 1,2 GB) la detección tardó unos seis segundos y la carpeta de exportación se generó en 0,7 segundos.
Pero primero quiero explicarte la idea, porque cuando la entiendas tomarás mejores decisiones con cualquier herramienta, DAW incluido.
Qué es realmente el límite de una toma
Cuando miras la forma de onda de una sesión, las tomas saltan a la vista: bloques de voz con tramos planos entre ellos. La detección de silencio no es más que una versión formal de lo que hace tu ojo, con dos números.
El primer número es un umbral de nivel. Todo lo que quede por debajo cuenta como "silencio". En una cabina tratada con un previo decente, -40 dBFS es un valor por defecto razonable: el ruido de sala queda bastante por debajo, e incluso una consonante suave queda por encima.
El segundo número es una duración mínima. Es el que la gente olvida, y es el que más importa. Si cortas cada vez que el nivel baja del umbral, partirás una toma por la mitad en cada respiración, cada coma, cada pausa dramática. Así que la regla es: el nivel tiene que mantenerse por debajo del umbral al menos durante este tiempo para que el tramo silencioso cuente como hueco. Un valor por defecto de 1,0 segundo funciona porque una respiración dentro de una frase dura entre 200 y 500 milisegundos, mientras que la pausa entre dos lecturas (piensas, te recolocas, vuelves a empezar) casi siempre supera el segundo.
Ahora el tercer detalle, el que separa una toma limpia de una recortada: el margen. Cuando el detector encuentra dónde se detiene la voz y dónde vuelve a empezar, el corte no debería caer exactamente en esos puntos. Quieres un poco de ruido de sala a ambos lados, digamos 0,25 segundos, para que la toma empiece con un poco de aire antes de la primera sílaba y no le corte la cola a la última. Ese margen es también lo que permite que los clips vayan pegados unos a otros en el DAW sin sonar como si pasaran por una puerta de ruido.
Un consejo rápido: si tu cabina es más ruidosa de lo normal, sube el umbral (a -35 dBFS, por ejemplo) antes de tocar el silencio mínimo. Si haces muchas pausas a mitad de línea y las tomas se te están partiendo, sube el silencio mínimo a 1,5 segundos. Cambia una cosa a la vez y comprueba un tramo que conozcas bien.
Una cosa más sobre el corte en sí. Hay dos maneras de generar las piezas: decodificar el archivo completo, procesarlo y volver a codificar cada pieza, o copiar los bytes entre dos posiciones exactamente como están. La segunda es la que quieres. Un archivo WAV es PCM sin comprimir, así que una toma no es más que "las muestras de la 5.432.100 a la 5.501.000" del original. Un corte byte a byte deja intactos tu profundidad de bits y tu frecuencia de muestreo, es instantáneo y no puede introducir nada que no estuviera en la grabación. Un fundido minúsculo de unos pocos milisegundos en cada corte evita los clics, y ese debería ser el único procesado que ocurra.
Por qué los nombres de archivo deciden el orden
Aquí va algo que me costó vergonzosamente mucho interiorizar: un DAW no sabe nada de tus tomas. Cuando seleccionas 200 archivos en una carpeta y los sueltas en una pista, el orden en que aterrizan es el orden en que el explorador de archivos los entregó, y ese es el orden alfabético de los nombres. Así que si tus archivos se llaman take1.wav, take2.wav ... take10.wav, aterrizan como 1, 10, 11, 12, 2, 3. Si se llaman take001.wav, take002.wav y así sucesivamente, aterrizan en orden.
Los números con ceros a la izquierda en el nombre del archivo son todo el truco. Todo lo demás se construye sobre eso.
Pero este es el truco que hace que soltar la carpeta sea realmente útil: archivos diminutos de silencio. Si sueltas 200 clips en una pista, quedan pegados uno tras otro, lo cual es horrible para escucharlos. Lo que quieres es un segundo de aire después de cada toma. Así que escribes, entre cada par de tomas, un archivo WAV muy pequeño que no contiene más que silencio, y lo nombras para que se ordene justo después de la toma a la que sigue. Ahora, cuando lo seleccionas todo y lo sueltas, los silencios caen en su sitio y la sesión completa llega en una sola pista, espaciada, lista para escuchar. Haz que el hueco entre dos tomas de la misma línea sea de un segundo y el hueco donde la siguiente toma es de otra línea sea de dos segundos, y podrás oír los límites entre líneas sin mirar.
Orden de grabación frente a orden de guion
Ahora hablemos del orden, porque "en orden" significa dos cosas distintas.
Orden de grabación es el orden en que ocurrieron las cosas. La toma 37 va después de la 36 porque la dijiste más tarde. Si grabaste el guion de arriba abajo sin desvíos, el orden de grabación es el orden de guion y ya está.
Solo que las sesiones no van así. Haces la línea 20, el director te pide otra vez la 18, rehaces la 18 y la 19, y sigues con la 21. Ahora las piezas de la línea 18 están dispersas: algunas cerca del principio, otras por el medio. Orden de guion significa reunir todas las tomas de la línea 18, en la posición que la línea 18 tiene en el guion, sin importar cuándo las grabaste. Para eso necesitas saber, de cada toma, a qué línea pertenece. Esa es la información que la detección de silencio no puede darte, porque la detección de silencio solo sabe dónde está el silencio.
Entiendo que suena a mucho pedir. Dos apuntes honestos. Primero, sin guion, el orden de grabación está perfectamente bien: sigues teniendo clips numerados y espaciados en una pista en unos segundos, y ordenas de oído como siempre has hecho. Segundo, en el momento en que sabes qué línea es cada toma, la exportación puede numerar por línea, y al soltarlo en el DAW llega en orden de guion sin más, porque los nombres se ordenan así.
Ahora sí, hablemos de Takekeeper
Todo lo anterior es lo que hace Takekeeper, en una pestaña del navegador. Empezó como un script de línea de comandos en Python que cortaba una sesión por los silencios en archivos numerados para que un actor de voz los ordenara en FL Studio, y creció desde ahí. La interfaz está en inglés y español, y el manejo del guion y la transcripción están afinados para ambos idiomas.
La página de inicio es un titular y una zona donde soltar el archivo. En la captura de abajo también ves una grabación que ya se ha tocado, mart_full.wav, listada con reanudar y descartar: tus carriles, cortes y posición se guardan en el navegador mientras trabajas, así que cerrar la pestaña no te cuesta nada.
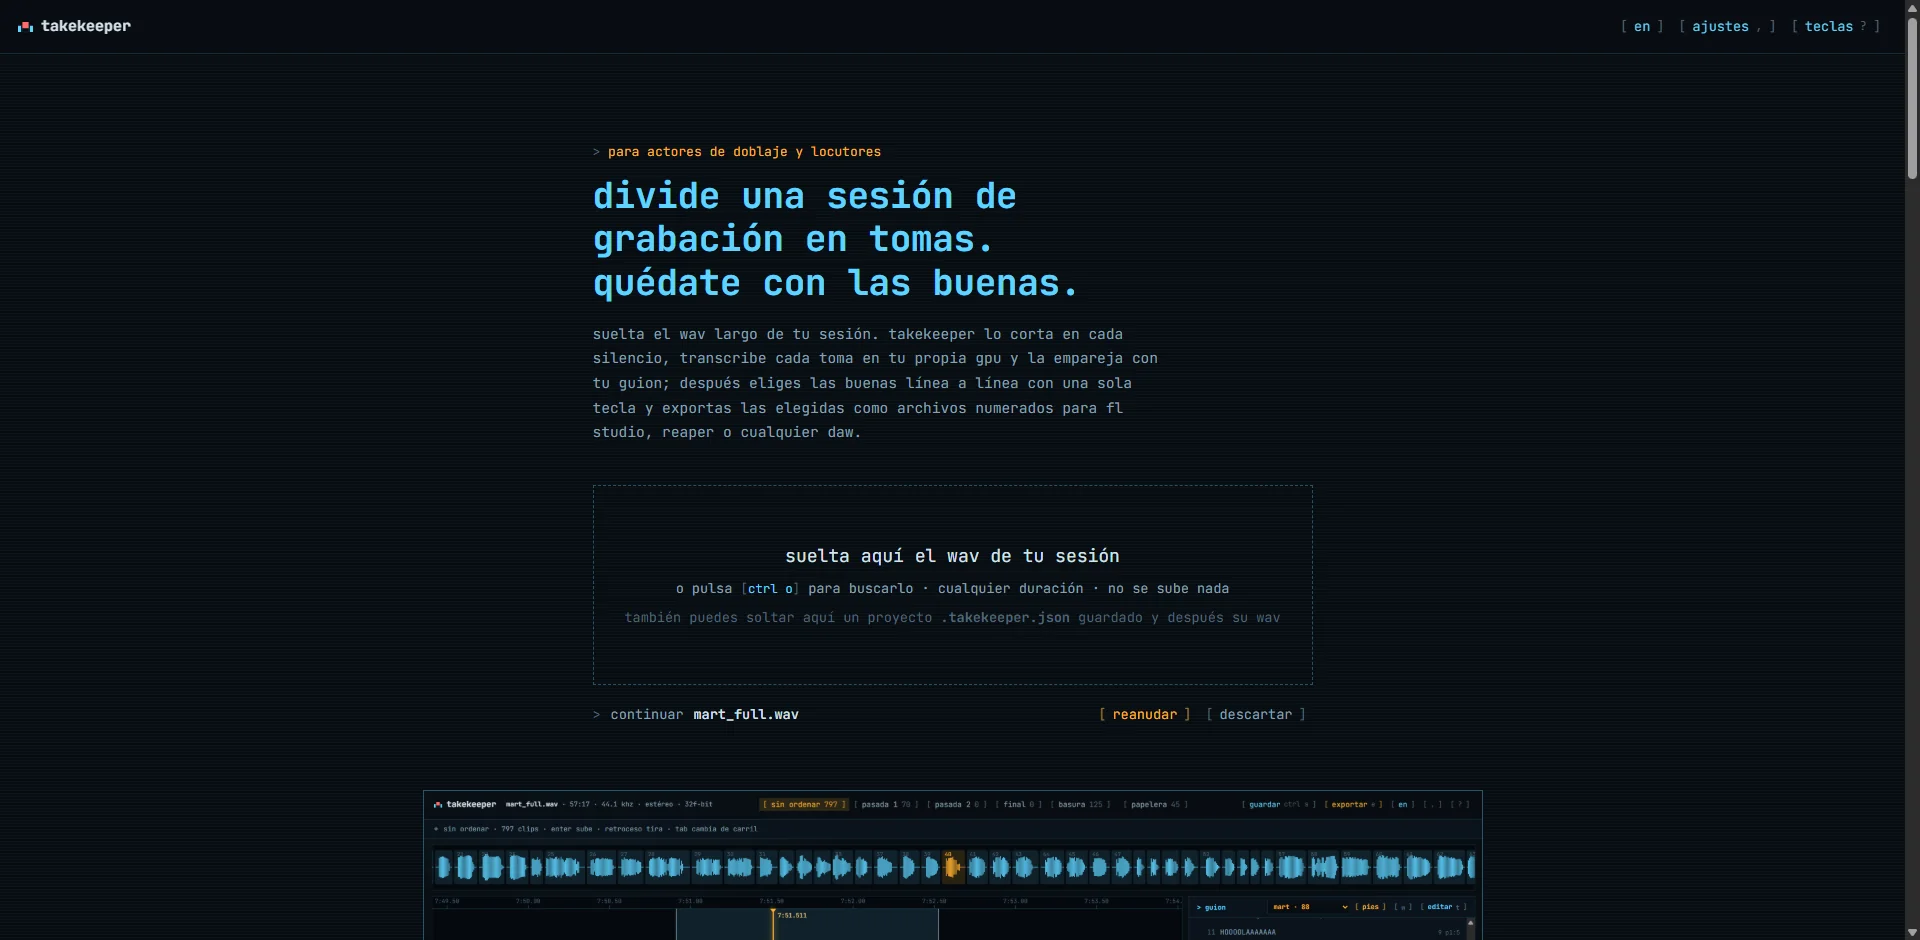
Página de inicio de Takekeeper con la zona para soltar el WAV de una sesión y una grabación abierta anteriormente listada con las opciones de reanudar y descartar
Suelta el WAV. No se decodifica entero: el archivo se lee en streaming y se mide el nivel de cada bloque de 20 ms. Donde el nivel se mantiene por debajo del umbral (por defecto -40 dBFS) durante más del silencio mínimo (por defecto 1,0 s), corta, dejando 0,25 s de ruido de sala a ambos lados. Las respiraciones y pausas cortas dentro de una toma no se tocan. Los tres números están en los ajustes si tu cabina o tu ritmo necesitan otra cosa.
Como cada toma se guarda como una posición de inicio y fin en el archivo original y no como una copia, una sesión de una hora y 1,2 GB carga en unos seis segundos y usa unos 35 MB de memoria. Los archivos WAV pueden tener cualquier duración; MP3, FLAC, OGG y M4A funcionan hasta unos 25 minutos.
Esto es lo que ves justo después de la detección, antes de ordenar nada ni pegar el guion: 848 clips en Sin ordenar, Descartes y Papelera vacíos, y el panel del guion a la derecha diciendo todavía que no hay guion. La toma #37 está seleccionada en 2:05.65, con 1,56 segundos de duración, con los marcadores IN y OUT mostrando dónde cayó el corte y 1,5 segundos de contexto a cada lado para que puedas juzgarla. Esto es lo que te da la detección de silencio por sí sola, y ya es utilizable.
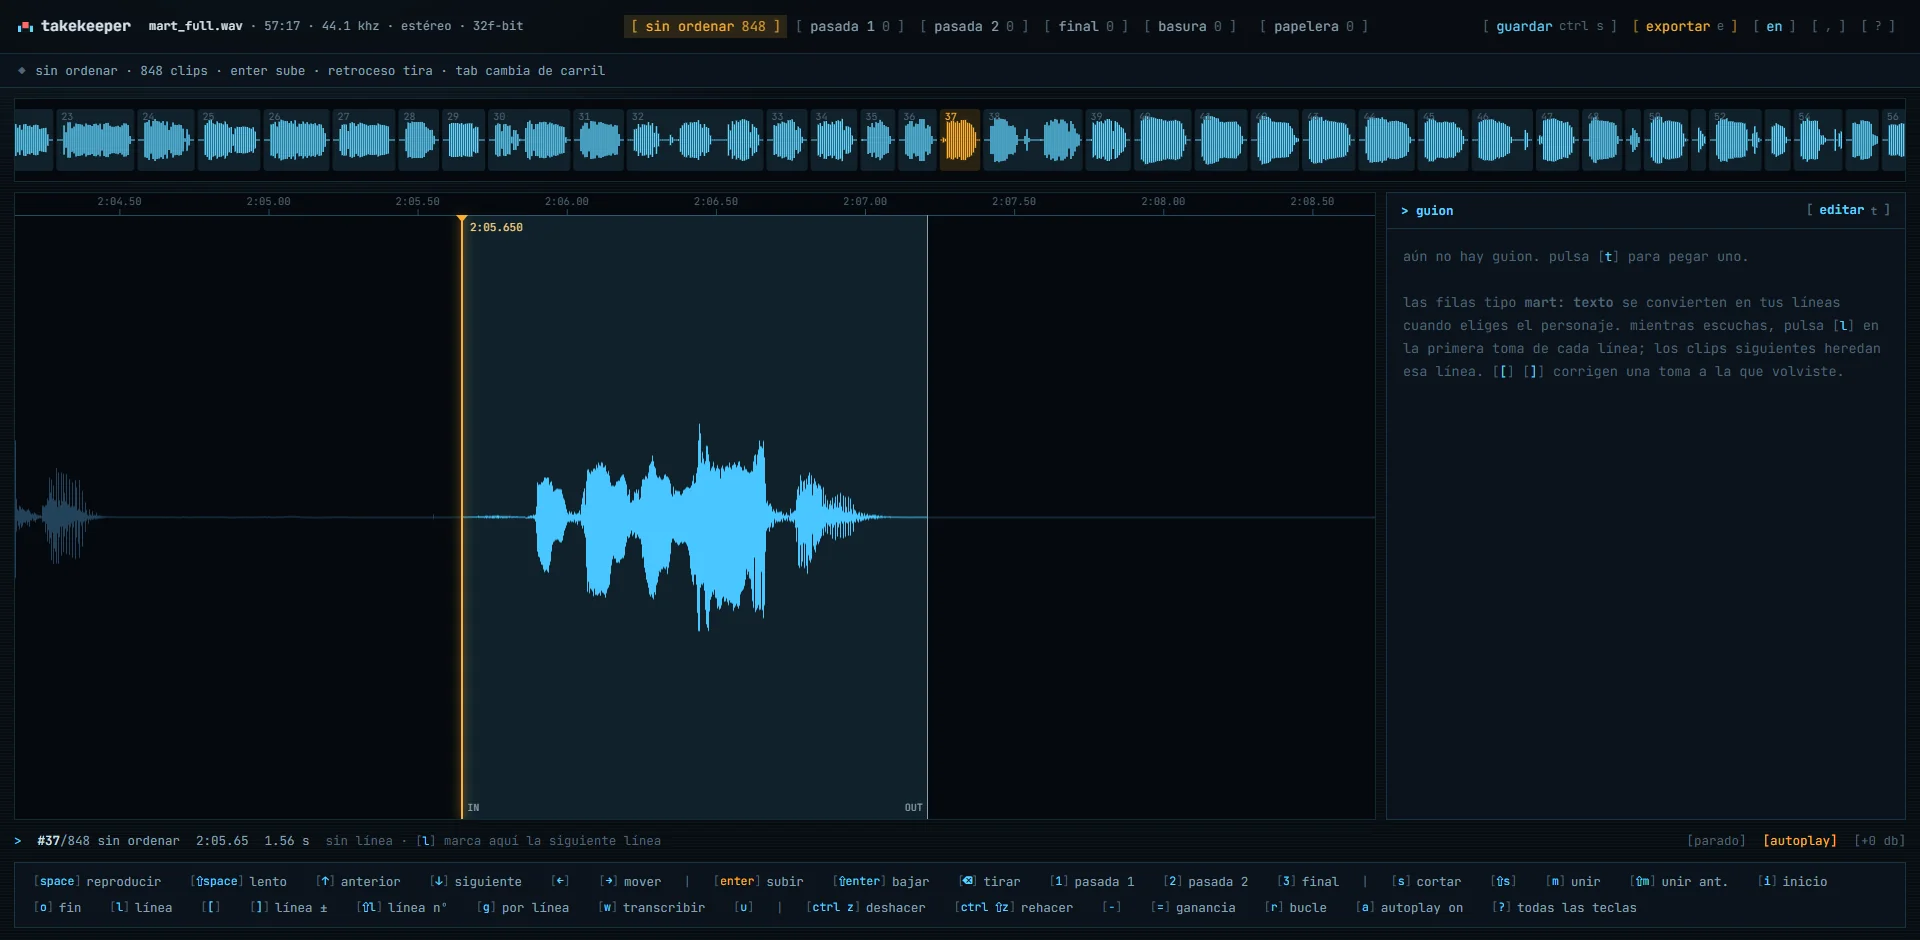
Takekeeper justo después de la detección de silencio: 848 tomas en el carril Sin ordenar, la toma 37 seleccionada en la forma de onda con los marcadores IN y OUT, y el panel del guion vacío
Desde aquí puedes ponerte a ordenar directamente. Las tomas se reproducen solas una tras otra; Enter asciende la toma actual al siguiente carril (Pase 1, Pase 2, Final), Retroceso la manda a la papelera, y no hacer nada la deja donde está. Cada tecla es también un botón de la barra de herramientas, así que quien use ratón puede hacer clic en carriles, tomas y forma de onda. Si un corte está mal, I y O mueven el inicio y el final, S divide, M fusiona con la toma siguiente y recupera el audio intermedio, y el deshacer es ilimitado. Si quieres ordenar sin transcripción, L marca "el guion continúa aquí" mientras escuchas, y cada clip posterior hereda esa línea.
Conseguir el orden de guion: el guion y la transcripción opcional
Pega el guion completo como texto plano con T. Las filas del tipo Mart: text se leen como líneas habladas; todo lo demás es acotación. La app lista los personajes que ha encontrado con su número de líneas, eliges el tuyo, y "línea 14" pasa a ser tu línea número 14. Una lista simple de líneas sin nombres también funciona.
Después, si quieres, pulsa W. Eso ejecuta el modelo Whisper de OpenAI dentro de la página, en tu propia GPU, y transcribe cada toma por separado. El modelo se descarga una sola vez (whisper-small, unos 410 MB, la opción segura para español; whisper-base, unos 140 MB, más o menos el doble de rápido y algo menos preciso). El audio nunca sale de la máquina. Cada toma se empareja entonces con la línea del guion a la que pertenece mediante una similitud de texto que tolera errores de transcripción y prefiere quedarse en la misma línea o pasar a la siguiente, de modo que una sesión con desvíos se empareja correctamente. En la sesión de referencia, las 88 líneas recibieron sus tomas, con 15 saltos hacia atrás y 4 saltos grandes en la grabación. Los emparejamientos dudosos se marcan y U los recorre uno a uno.
Dos apuntes honestos. Calcula unos diez minutos de procesado por cada hora de audio en un PC de gama media, más en máquinas más flojas (en una GPU NVIDIA, la sesión de referencia de 57 minutos tardó unos doce minutos con el modelo small), y deja que corra en vez de hacer otras cosas a la vez. Y tras el emparejamiento, las tomas vacías o sin palabras (una respiración, una claqueta, una tos) pasan automáticamente al carril Descartes: 174 en la sesión de referencia. Descartes es una suposición, no la Papelera. A veces caen ahí líneas reales muy cortas, así que échale un vistazo rápido a ese carril. Nunca se lleva la última toma que le queda a una línea.
La transcripción también mejora los cortes: una toma con varias lecturas dentro se vuelve a cortar en lecturas sueltas (93 tomas así se convirtieron en 238 en la sesión de referencia), un arranque fallido seguido de la lectura buena se separa, y una línea que una pausa partió en dos se vuelve a fusionar. Los otros artículos de esta serie entran en detalle en el panel del guion y en la pasada de transcripción; este trata de llevar los clips a FL Studio.
La exportación y el arrastre a FL Studio
Pulsa E. El diálogo de abajo es la exportación del carril Pase 1 en la sesión de referencia: 70 clips, 1:52.8 de audio, 69 huecos que suman 1:24.0 de silencio. Eliges el orden (por línea para orden de guion, por tiempo para orden de grabación), el carril a exportar y el formato: una carpeta escrita directamente en el disco, un zip o un solo archivo, un único WAV fusionado con un hueco fijo entre tomas. Debajo, el interruptor de huecos de silencio entre tomas y los dos campos que los definen: 1 segundo después de cada toma, 2 segundos cuando la siguiente toma es de otra línea. Las tomas sin línea van al final.
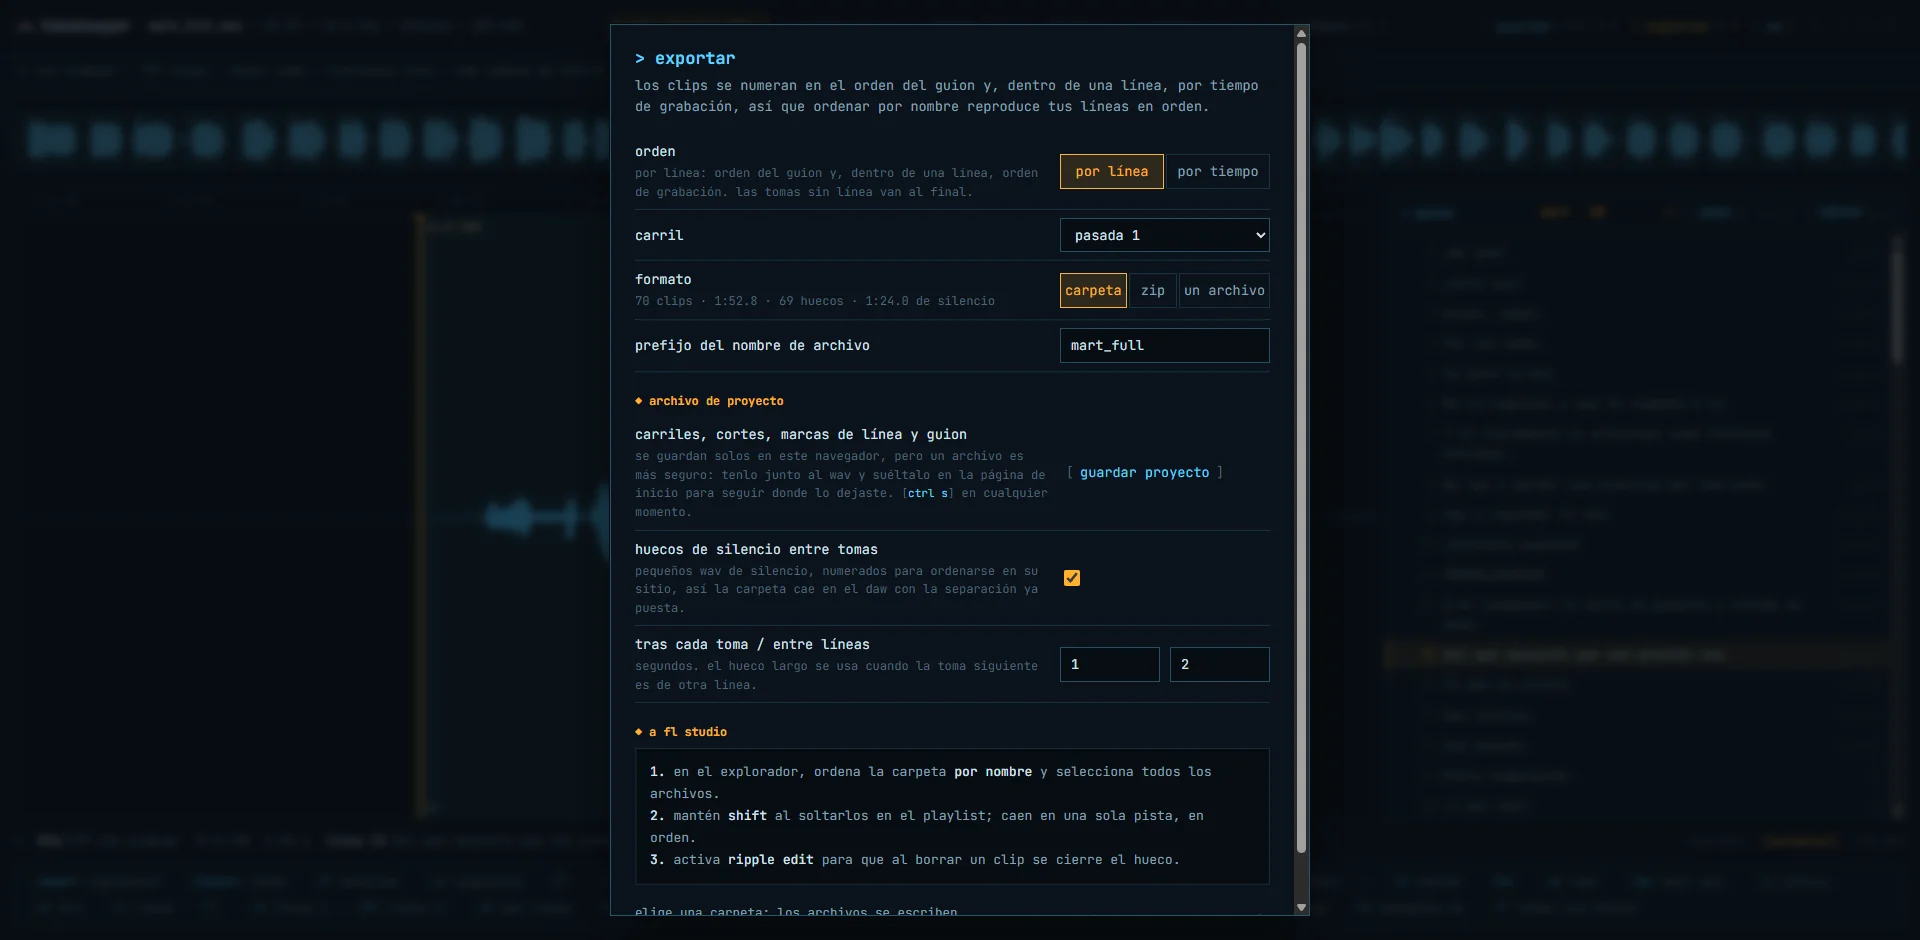
Diálogo de exportación de Takekeeper para el carril Pase 1 con 70 clips: orden por línea, formato carpeta, huecos de silencio activados con 1 segundo después de cada toma y 2 segundos entre líneas, e instrucciones para soltarlos en FL Studio
Los archivos salen como cortes byte a byte en la profundidad de bits y la frecuencia de muestreo de la propia grabación, con un fundido de 5 ms en cada corte, y con nombres pensados para ordenarse: mart_001a_line014.wav lleva el número de secuencia, la letra de la toma y el número de línea. Los archivos de hueco se nombran para caer en su sitio entre ellos. En la sesión de referencia, 848 archivos se generaron en 0,7 segundos.
Y luego el arrastre, tal y como lo indica el propio diálogo:
- En tu explorador de archivos, ordena la carpeta exportada por nombre y selecciona todos los archivos.
- Mantén pulsada Shift mientras los sueltas en el playlist de FL Studio; caen en una sola pista, en orden, con los huecos ya puestos.
- Activa Ripple edit en FL Studio para que al borrar un clip se cierre el hueco que deja.
Eso es todo. Ordena de oído en esa única pista, borra lo que no quieras, y la pista se va compactando sobre la marcha. Si hiciste la pasada de transcripción, los clips ya están agrupados por línea en orden de guion. Si no, están en orden de grabación, que es lo que habrías tenido de todos modos, solo que ya cortados y espaciados.
Nota sobre navegadores, dicha sin rodeos: Chrome o Edge en escritorio tienen todo el conjunto (exportación de carpeta directa al disco, transcripción por WebGPU, reanudar con un clic). Firefox ordena sin problema, pero descarga un zip en su lugar y transcribe en la CPU, que es lento. Los móviles y las tabletas no son el objetivo. Ctrl+S escribe un pequeño .takekeeper.json junto a la grabación para que puedas retomar el trabajo en otra máquina.
Antes y después
A la manera del DAW, más o menos lo que yo hacía antes:
- Importa el WAV de una hora en una pista.
- Haz zoom, busca cada silencio, corta. Repite unos cientos de veces.
- Separa los clips arrastrándolos para poder oír dónde termina cada uno.
- Escucha, arrastra las buenas a una segunda pista, y luego a una tercera para las finalistas.
- Vuelve a escuchar para averiguar qué línea es cada clip, y apúntalo en algún sitio.
- Coloca las finalistas en orden de guion a mano, huecos incluidos.
- Exporta o consolida, y reza para que los nombres tengan sentido la semana que viene.
A la manera de Takekeeper:
- Abre takekeeper.com en Chrome o Edge y suelta el WAV. Unos seis segundos.
- Opcional: pega el guion (T), elige tu personaje, lanza la transcripción (W). Unos diez minutos por hora de audio; después echa un ojo a Descartes.
- Quédate en Sin ordenar, deja que las tomas se reproduzcan solas, Enter para ascender, Retroceso para tirar. Repite por carril hasta que Final tenga una toma por línea.
- Exporta (E) el carril que quieras como carpeta con archivos de hueco, ordenado por línea.
- Ordena la carpeta por nombre, selecciona todo, suéltalo con Shift en el playlist de FL Studio y activa Ripple edit.
El trabajo creativo, elegir qué lectura es la buena, es el mismo en ambos casos. Lo que ha cambiado es que la parte mecánica pasó de casi toda una tarde a unos segundos más lo que dediques a escuchar de verdad. Ese es todo el sentido: Takekeeper no elige las tomas por ti, elimina las razones por las que te daba pereza elegirlas.
La transcripción juzga qué es una toma, nunca lo buena que es. Esa parte sigue siendo tuya.- Pablo Domínguez
Preguntas que también se hace la gente
¿Necesito el guion para usar Takekeeper?
No. La detección de silencio por sí sola corta la sesión en tomas en unos segundos y la exportación sale en orden de grabación, numerada y espaciada. El guion y la transcripción opcional son lo que convierte eso en orden de guion.
¿La detección de silencio me partirá las tomas por la mitad en las respiraciones?
No con un silencio mínimo razonable. Las respiraciones y las pausas a mitad de frase duran unos cientos de milisegundos; el valor por defecto de 1,0 segundo hace que solo los tramos silenciosos más largos que eso cuenten como huecos, y puedes subirlo si haces muchas pausas.
¿Mi grabación se sube a algún sitio?
No. El archivo se lee del disco dentro del navegador y las exportaciones se escriben de vuelta en el disco. El único tráfico de red es cargar la app y, si usas la transcripción, la descarga única del modelo.
¿Por qué los clips caen desordenados cuando los arrastro a FL Studio?
Porque el DAW coloca los archivos en el orden alfabético de sus nombres. La numeración con ceros a la izquierda (001, 002, ...) lo arregla, y así es como Takekeeper nombra sus exportaciones, archivos de hueco incluidos, para que una carpeta ordenada caiga en orden.
¿Funciona en Firefox o en el móvil?
Firefox ordena sin problema, descarga un zip en vez de escribir en una carpeta y transcribe en la CPU, que es lento. Los móviles y las tabletas no son el objetivo; Chrome o Edge en escritorio lo tienen todo.
También disponible en

Pablo Dominguez
Full Stack Developer passionate about building interesting projects and learning new skills.